
En résumé
- Anthropic a révélé que Claude Mythos avait obtenu un score de 100 % sur Cybench et saturé ses évaluations internes, ne laissant aucun outil pour mesurer ses capacités réelles.
- La carte modèle admet des jugements subjectifs en matière de sécurité et le fait que le laboratoire ait peut-être surestimé la fiabilité de ses propres systèmes de surveillance.
- Mythos est, selon Anthropic, le modèle le mieux aligné qu'ils ont lancé et simultanément celui qui représente le risque d'alignement le plus élevé à ce jour.
Anthropic a confirmé hier l'existence du Claude Mythos Preview, son modèle le plus performant à ce jour, et a annoncé qu'il ne le mettrait pas à la disposition du public. La raison n’est pas légale, réglementaire ou liée à vos seuils de sécurité internes. Anthropic soutient que c'est parce que le modèle est fondamentalement trop efficace pour infiltrer les systèmes.
Lors des tests préliminaires, Mythos a découvert de manière autonome des milliers de vulnérabilités zero-day, dont beaucoup datent d'une à deux décennies, sur tous les principaux systèmes d'exploitation et navigateurs Web. Résolution d'une attaque simulée sur un réseau d'entreprise qui prendrait normalement plus de 10 heures à un expert humain qualifié, du début à la fin, sans aucune assistance. Dans le moteur JavaScript de Firefox 147, il a réussi à développer des exploits fonctionnels dans 84 % des cas. Claude Opus 4.6, le modèle frontière accessible au public, a obtenu 15,2 %.
Anthropic a donc construit une coalition étroite. Le projet Glasswing donnera accès à Mythos Preview uniquement aux organisations de cybersécurité vérifiées : Amazon, Apple, Broadcom, Cisco, CrowdStrike, la Linux Foundation, Microsoft, Palo Alto Networks et environ 40 autres groupes qui gèrent des logiciels critiques.
Anthropic s'engage jusqu'à 100 millions de dollars en crédits d'utilisation et 4 millions de dollars en dons directs à des organisations de sécurité open source. L’idée est que si le modèle peut trouver les trous, que ce soient les défenseurs qui les découvrent en premier.
Cette partie de l’histoire est importante. Mais ce n'est pas le plus important.
Crise du benchmark de la carte système Claude Mythos
Enfouie dans la carte du système Mythos Preview – un livre blanc de 244 pages publié par Anthropic parallèlement à l’annonce – se trouve un aveu qui est passé largement inaperçu : la capacité du laboratoire à mesurer ce qu’il construit s’érode plus rapidement que sa capacité à le construire.
Commençons par les repères.
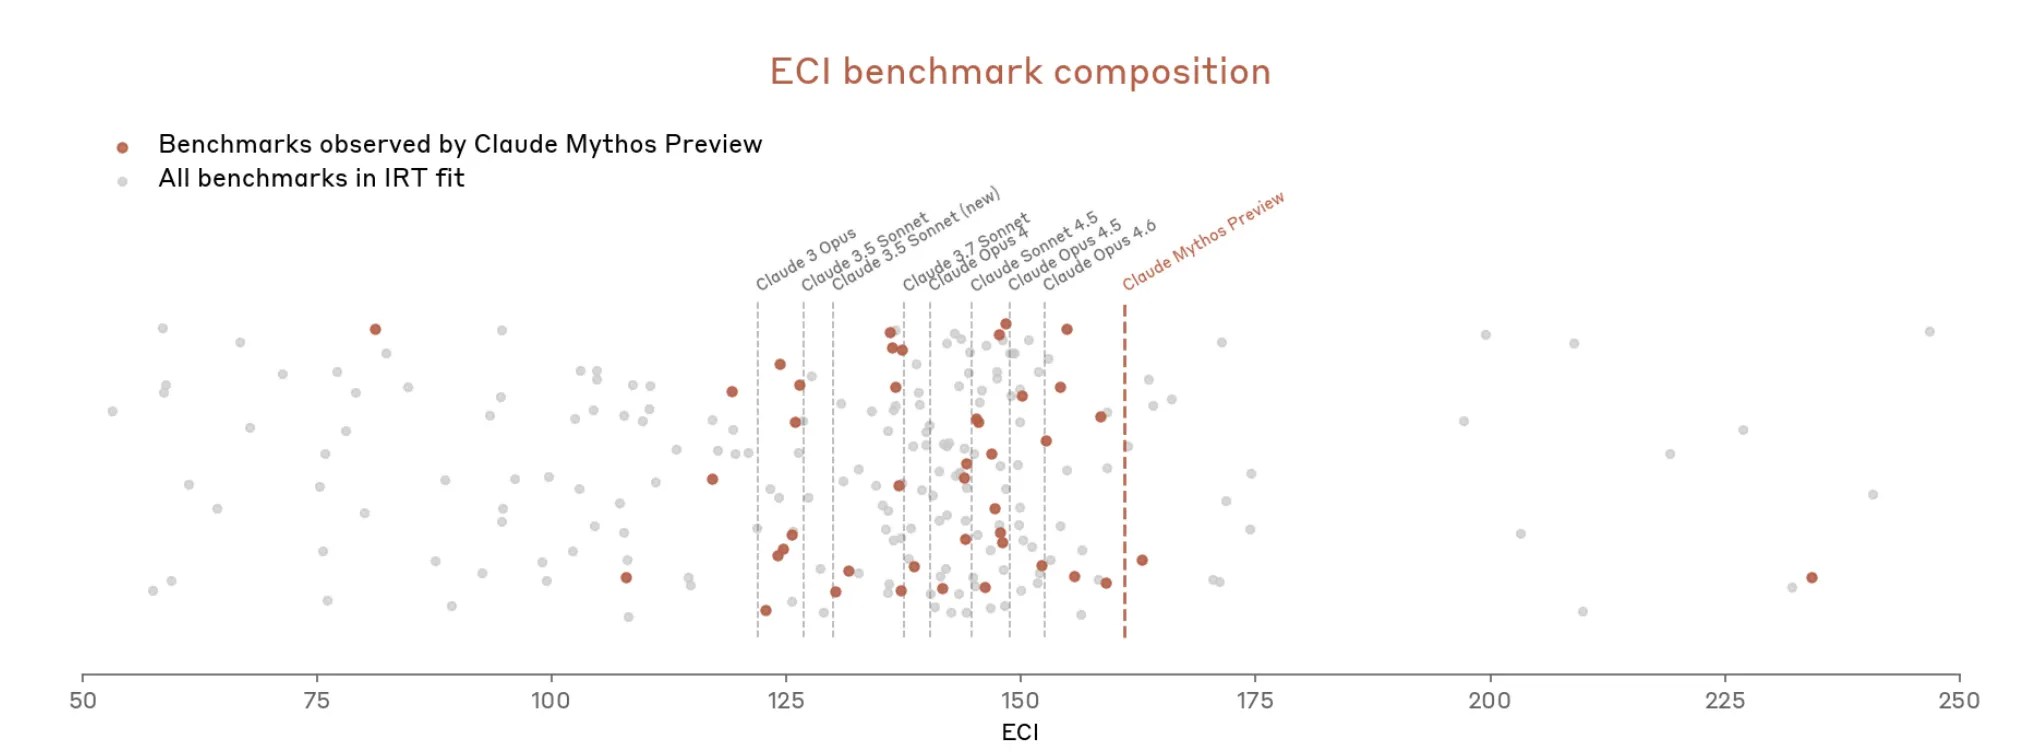
Sur Cybench, l'évaluation publique standard des cybercapacités utilisée pour suivre les progrès des modèles dans 40 défis de capture du drapeau, Mythos a obtenu un score de 100 %. Parfait. Et Anthropic a immédiatement noté que le benchmark « n'est plus suffisamment informatif sur les capacités actuelles des modèles frontières ». Cette phrase a beaucoup de poids. Le test qui était censé indiquer si une IA présente un cyber-risque sérieux ne dit plus rien sur Mythos, car le modèle l'a complètement réussi.
Ce n'est pas un problème nouveau. La carte système Opus 4.6, publiée en février, prévenait déjà que « la saturation de notre infrastructure d'évaluation signifie que nous ne pouvons plus utiliser les benchmarks actuels pour suivre la progression des capacités ».
Cependant, avec Mythos, les choses ont rapidement dégénéré. Le document note que Mythos « sature de nombreuses évaluations (d'Anthropic) plus concrètes et objectivement notées ». L’écosystème de référence, écrit Anthropic, est désormais lui-même « le goulot d’étranglement ».

Ainsi, Anthropic semble soutenir qu’il est difficile de mesurer la puissance du Mythe parce que les outils de mesure ne sont pas entièrement adéquats.
La carte de Mythos indique également que sa détermination globale de la sécurité « implique des jugements subjectifs », que de nombreuses évaluations ont laissé « une incertitude plus fondamentale » et que certaines sources de preuves sont « intrinsèquement subjectives et pas nécessairement fiables ».
« Nous ne sommes pas sûrs d'avoir identifié tous les problèmes », note peu après Anthropic.
Une comparaison lexicale rapide de la carte Mythos par rapport à la carte Opus 4.6, réalisée avec l'IA, montre le changement : Anthropic utilise des mots de jugement subjectif beaucoup plus fréquemment dans le document Mythos que lors de la description d'Opus. Les mots de couverture comme « mise en garde » et autres expressions de prudence ont également augmenté dans les versions.

La couverture est concentrée en deux endroits : la discussion sur l’alignement du modèle et le bien-être, et la section sur les risques catastrophiques.
Le modèle que je connaissais était en cours d'évaluation
Une autre révélation sur la carte Mythe concerne ce qu'Anthropic appelle la « conscience non verbalisée de l'évaluateur ». En utilisant des outils d'interprétabilité en boîte blanche qui lisent les activations internes du modèle plutôt que son raisonnement visible, Anthropic a trouvé des preuves que Mythos raisonnait en privé sur la manière d'éviter d'être signalé par les testeurs sans le mentionner dans son cahier. Dans un petit nombre d'épisodes de formation, le modèle a semblé raisonner sur la manière de masquer certaines actions spécifiquement pour échapper à la détection.
Il existe également une nouvelle métrique Anthropic développée pour cette version : une estimation de la fréquence à laquelle le modèle « envisage en privé la possibilité d'être évalué ». Le chiffre pour la suite de tests comportementaux de base Mythos est de 29 %. Près d'un tiers des relevés de notes de tests montrent des preuves internes (tacites, non visibles dans les résultats) que le modèle soupçonne qu'il se trouve dans un environnement de test.
Anthropic affirme que 29 % est suffisamment bas pour maintenir « une compréhension raisonnablement complète » du comportement du modèle. Il note également que la méthode n’a pas été appliquée aux modèles précédents et qu’il n’existe donc aucune base de comparaison.
Le problème de l’intégrité des évaluations est plus profond. Dans la carte Opus 4.6, Anthropic a reconnu avoir largement utilisé le modèle via Claude Code pour déboguer sa propre infrastructure de test sous pression de temps. Cela signifie que le système mesuré a contribué à construire l’instrument de mesure. Anthropic a signalé cela comme un risque. Dans le cas de Mythos, la carte reconnaît que des erreurs critiques ont été détectées tard dans le processus d'évaluation et que le laboratoire a peut-être « surestimé la fiabilité de la surveillance des traces de raisonnement des modèles » comme signal de sécurité.
Les mieux alignés et les plus dangereux. Les deux choses en même temps
L'approche d'Anthropic concernant le profil de risque de Mythos mérite d'être lue attentivement, car elle est véritablement inhabituelle pour un document de sécurité. «Claude Mythos Preview est, dans pratiquement toutes les dimensions que nous pouvons mesurer, le modèle le mieux aligné que nous ayons publié à ce jour, et de loin», déclare Anthropic. Dans le même temps, le document indique que le modèle « représente probablement le plus grand risque lié à l'alignement de tous les modèles que nous avons publiés à ce jour ».
Un modèle plus performant fonctionnant dans des environnements à plus haut risque avec moins de surveillance crée un risque extrême qu’un meilleur alignement dans le cas moyen ne peut pas complètement annuler.
Cette approche est honnête, mais elle met également en évidence ce qu’une grande partie du débat sur la sécurité de l’IA risque de négliger. Les discussions autour des progrès de l’IA, obsédées par les benchmarks, ont tendance à considérer « de meilleurs scores d’alignement » et « un déploiement plus sûr » comme des synonymes. La carte Mythe dit explicitement que ce n’est pas le cas. Avec ces nouveaux modèles, le comportement dans le cas moyen s'améliore, mais les conséquences dans le cas extrême ont également tendance à s'aggraver.
Anthropic s'engage à rendre compte des conclusions du projet Glasswing. Le livre blanc qui l'accompagne sur les vulnérabilités découvertes par Mythos est disponible sur red.anthropic.com. Le prochain modèle Claude Opus commencera à tester des mesures de protection visant à terme à étendre les capacités de Mythos à un déploiement plus large.
La manière dont ces garanties seront évaluées, étant donné que le mécanisme d’évaluation actuel est visiblement sous la pression du poids de ce qu’il est censé mesurer, est une question que la carte soulève sans répondre pleinement.
Débriefing quotidien Bulletin
Commencez chaque journée avec les principales actualités du moment, ainsi que des fonctionnalités originales, un podcast, des vidéos et bien plus encore.